Content
<!-- mcp-name: io.github.ZahiriNatZuke/local-delegate -->
# local-delegate
**Delega tareas mecánicas texto→texto a un LLM local para conservar la cuota de tu suscripción de Claude.**
Un servidor MCP (stdio) que es cliente **genérico** de cualquier endpoint OpenAI-compatible —
llama-swap, Ollama, LM Studio, vLLM.
[](https://pypi.org/project/local-delegate-mcp/)
[](https://github.com/ZahiriNatZuke/local-delegate/actions/workflows/ci.yml)
[](./LICENSE)
## Demo
<!-- URL absoluta a raw.githubusercontent.com para que la imagen también se renderice en
PyPI (los links relativos solo se resuelven dentro de GitHub). -->
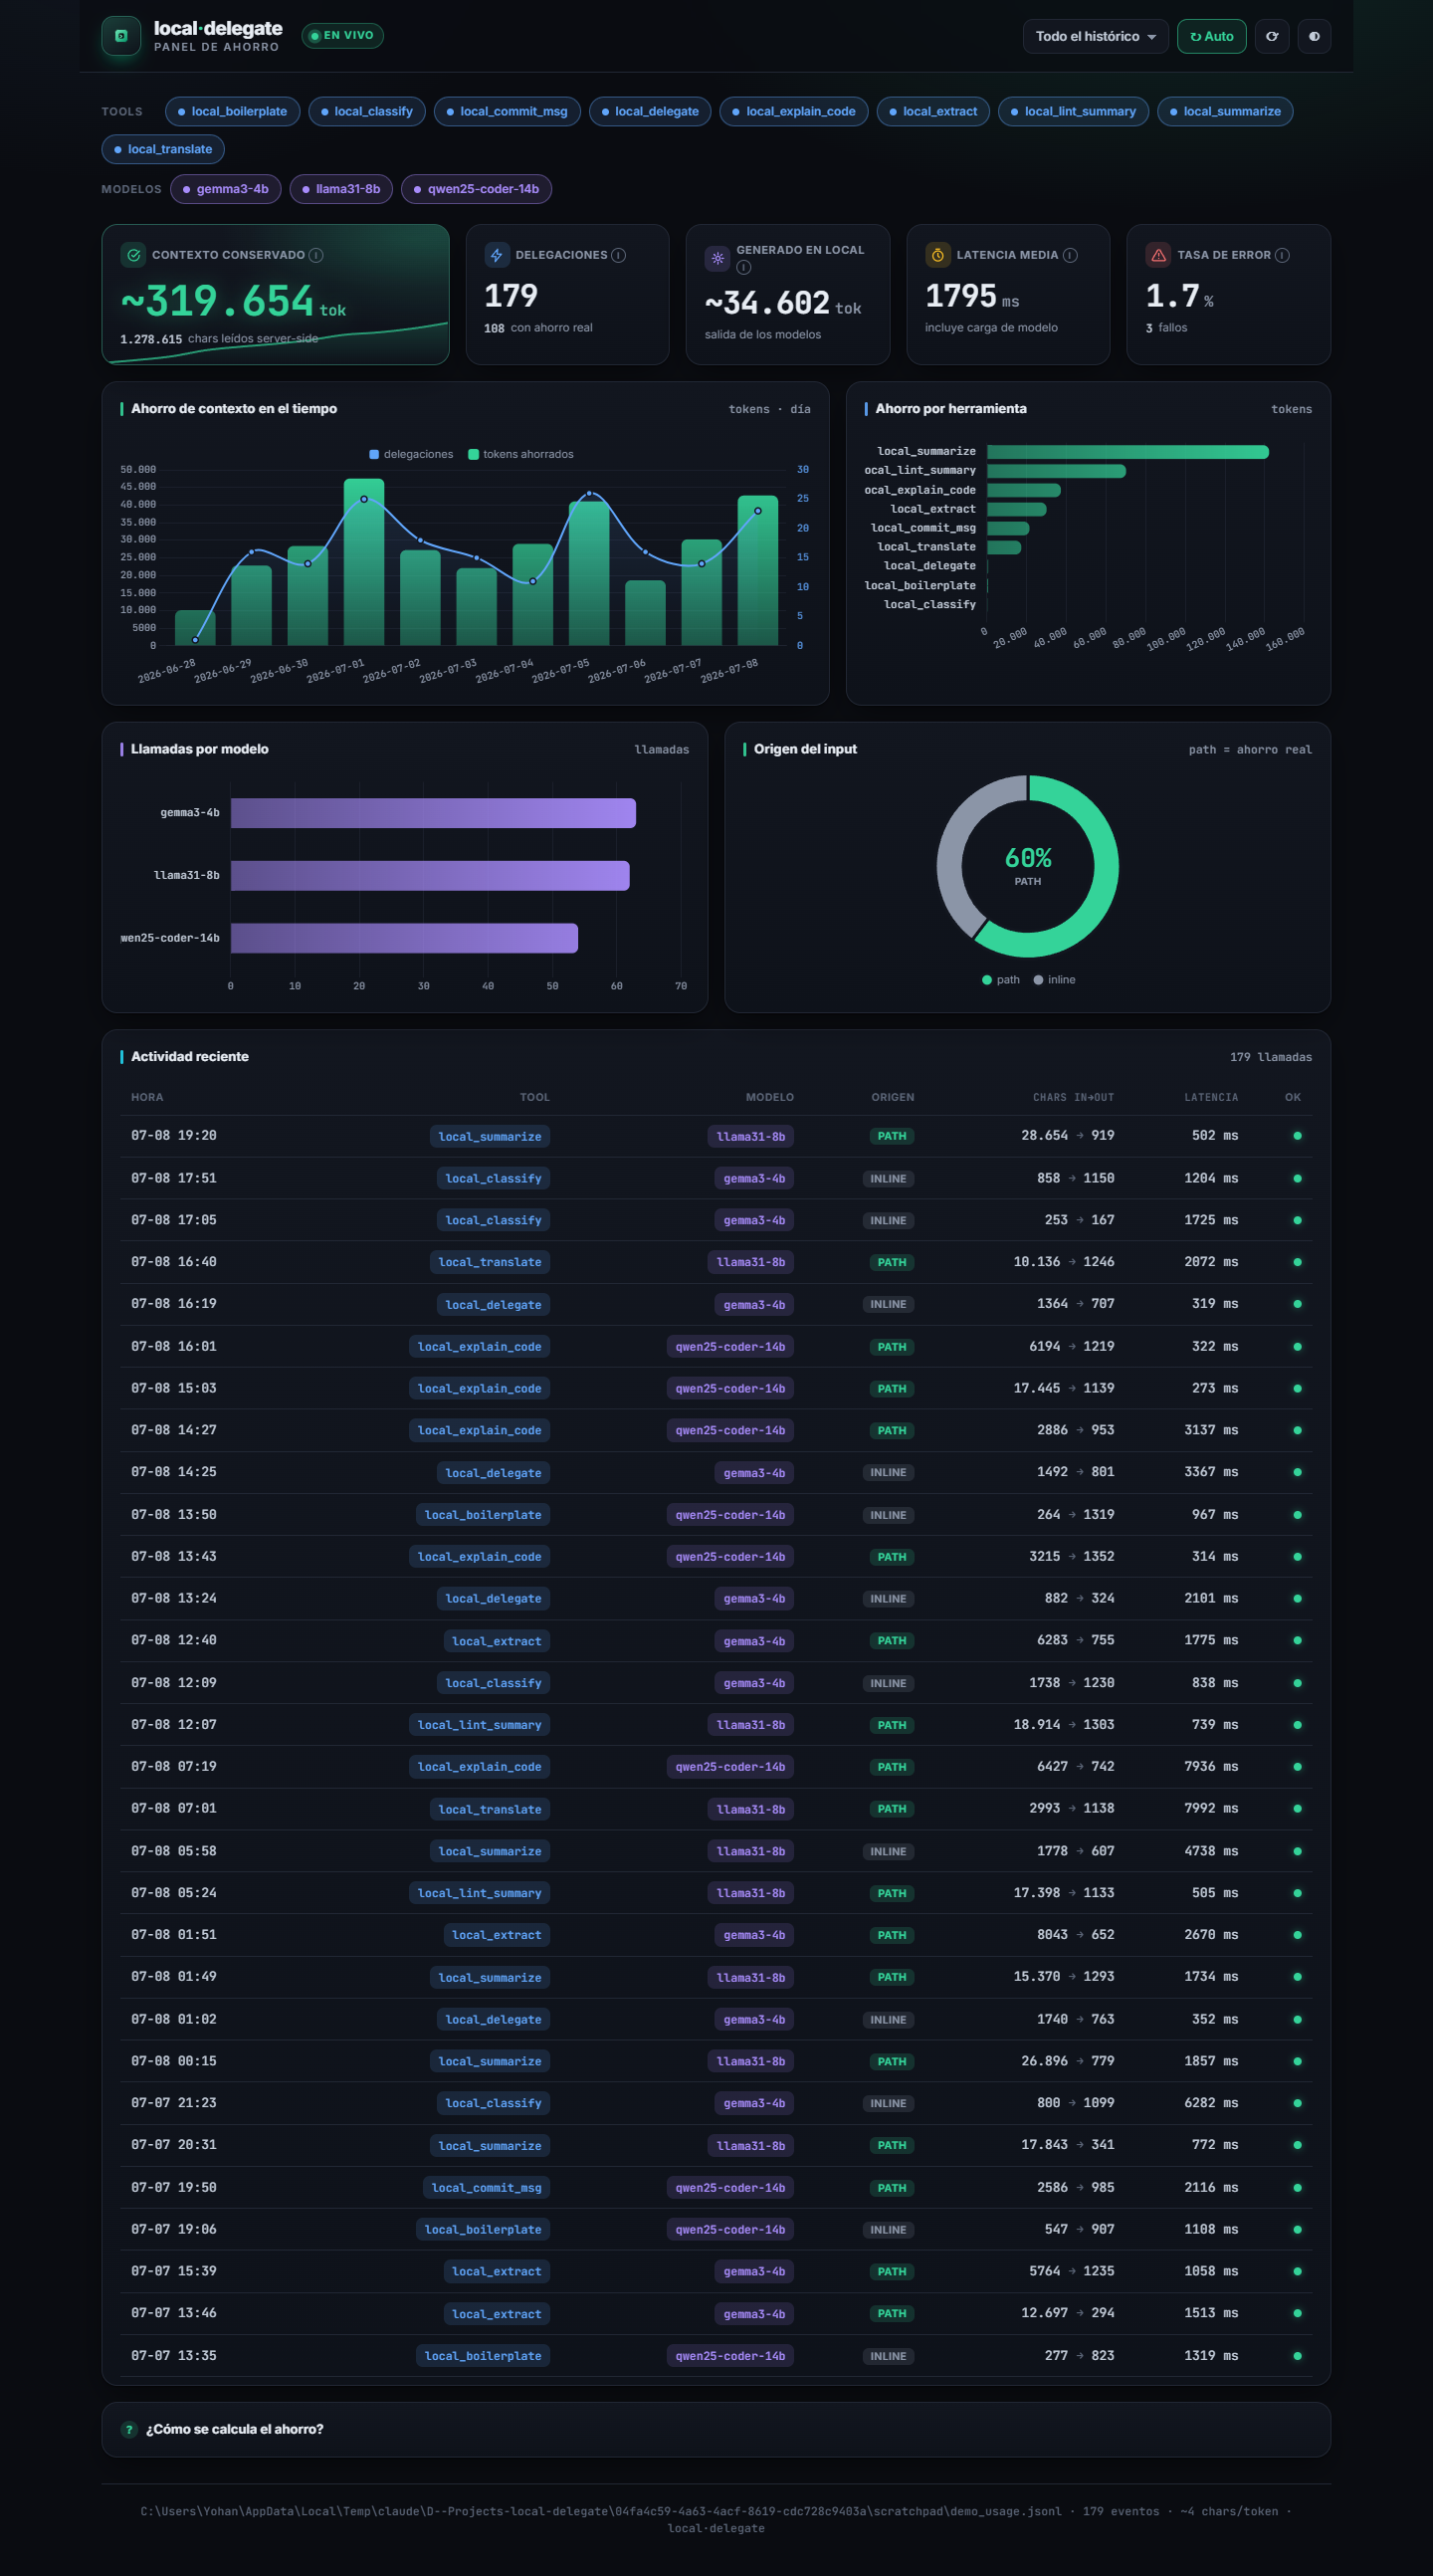
*Dashboard embebido (datos de ejemplo): estado del backend local (modelos montados, delegaciones en curso, tools MCP), RAM/VRAM del sistema con consumo por proceso, tokens de contexto conservados, ahorro por herramienta y modelo, y actividad reciente paginada. Se sirve en `http://127.0.0.1:9393`.*
## ¿Por qué?
Cuando Claude tiene que resumir un log enorme, clasificar, extraer campos o generar boilerplate,
gasta cuota de tu suscripción en trabajo **mecánico**. `local-delegate` expone esas tareas como
tools MCP que corren en un LLM **local**: pasas `path` en vez de `text` y el archivo se lee
**del lado del servidor**, así el contenido grande **nunca entra al contexto de Claude**. Solo
vuelve el resultado corto — cuota que no gastaste.
## Instalación rápida
Con [`uv`](https://docs.astral.sh/uv/) no hay nada que instalar: `uvx` baja y ejecuta el paquete aislado.
Añádelo a tu config de MCP (Claude Desktop / Claude Code):
```json
{
"mcpServers": {
"local-delegate": {
"command": "uvx",
"args": ["local-delegate-mcp"]
}
}
}
```
Ver plantillas completas en [`examples/`](./examples).
## Requisitos
Un **endpoint OpenAI-compatible** ya corriendo, accesible en `LOCAL_DELEGATE_BASE_URL`
(default `http://127.0.0.1:9292/v1`). Cualquiera sirve:
- **llama-swap** — ver [recipe con GPU Blackwell](./docs/recipes/llama-swap-blackwell.md).
- **Ollama** — `http://127.0.0.1:11434/v1`.
- **LM Studio**, **vLLM**, o cualquier servidor que hable la API de OpenAI.
El paquete **no arranca** ningún backend por defecto (`LOCAL_DELEGATE_AUTOSTART=0`). El
auto-arranque de llama-swap es opt-in (ver tabla de configuración).
## Tools
Pasar `path` (en vez de `text`) hace que el MCP lea el archivo server-side → ahorro real de cuota.
| Tool | Qué hace | Rol de modelo (default) |
|---|---|---|
| `local_summarize` | Resume texto o archivo | mecánico / largo (auto) |
| `local_classify` | Devuelve UNA etiqueta de una lista | mecánico |
| `local_extract` | Extrae campos → objeto JSON (con `response_format` schema) | mecánico / largo (auto) |
| `local_boilerplate` | Genera código desde una spec | código |
| `local_delegate` | Escape genérico texto→texto | mecánico (o el que pases) |
| `local_lint_summary` | Resume logs de lint/tests/CI | mecánico / largo (auto) |
| `local_commit_msg` | Mensaje de commit desde un diff | código |
| `local_translate` | Traduce texto o archivo | mecánico / largo (auto) |
| `local_explain_code` | Explica código en prosa | código |
| `local_describe_image` | Describe una imagen o responde una pregunta sobre ella (imagen→texto) | visión |
| `local_status` | Diagnóstico de solo lectura: backend, catálogo, log, VRAM, RAM de sistema | — (no llama al backend de chat) |
Los modelos locales **no** usan tool-calling: el server arma el prompt + guardrails, hace POST al
endpoint y devuelve **solo texto**.
## Configuración
Todo por variables de entorno; nada hardcodeado. Los ids de modelo default son solo eso —
cámbialos por los de tu backend.
| Variable | Default | Descripción |
|---|---|---|
| `LOCAL_DELEGATE_BASE_URL` | `http://127.0.0.1:9292/v1` | Endpoint OpenAI-compatible |
| `LOCAL_DELEGATE_API_KEY` | *(vacío)* | Bearer token, si tu endpoint lo exige |
| `LOCAL_DELEGATE_TIMEOUT` | `180` | Timeout HTTP (segundos) |
| `LOCAL_DELEGATE_LOG_DIR` | *(dir de datos de usuario)* | Directorio de los `usage-YYYYMM.jsonl` rotados por mes |
| `LOCAL_DELEGATE_LOG` | *(vacío = rotación activa)* | Si se fija, ruta de un `usage.jsonl` explícito sin rotar (compatibilidad) |
| `LOCAL_DELEGATE_MODEL_MECHANICAL` | `gemma3-4b` | Modelo para clasificar/extraer/resumen corto |
| `LOCAL_DELEGATE_MODEL_LONG` | `llama31-8b` | Modelo para documentos largos |
| `LOCAL_DELEGATE_MODEL_CODE` | `qwen25-coder-14b` | Modelo para código |
| `LOCAL_DELEGATE_MODEL_FAST` | `qwen35-2b` | Modelo ultrarrápido / trivial |
| `LOCAL_DELEGATE_MODEL_VISION` | `qwen3-vl-8b` | Modelo de visión para `local_describe_image` |
| `LOCAL_DELEGATE_MAX_IMAGE_MB` | `8` | Tope de tamaño de imagen para `local_describe_image` |
| `LOCAL_DELEGATE_LONG_INPUT_CHARS` | `6000` | Umbral mecánico↔largo |
| `LOCAL_DELEGATE_JSON_SCHEMA` | `auto` | `response_format` con schema en `local_extract`: `auto`/`on`/`off` |
| `LOCAL_DELEGATE_FEEDBACK` | `1` | Línea de ahorro anexada al resultado cuando `source=path` (`0` la apaga) |
| `LOCAL_DELEGATE_ALLOWED_DIRS` | *(vacío = sin restricción)* | Raíces permitidas para `path`, separadas por `;` |
| `LOCAL_DELEGATE_WEB` | `1` | Web de métricas embebida (`0` para desactivar) |
| `LOCAL_DELEGATE_WEB_HOST` / `_PORT` | `127.0.0.1` / `9393` | Host/puerto de la web |
| `LOCAL_DELEGATE_AUTOSTART` | `0` | Auto-arranque de llama-swap (opt-in) |
| `LLAMASWAP_EXE` / `LLAMASWAP_CONFIG` / `LLAMASWAP_LISTEN` | — | Solo si `AUTOSTART=1` |
## La métrica de ahorro
El MCP registra cada llamada en un log rotado por mes y sirve un **dashboard** en
`http://127.0.0.1:9393`, con selector de rango y visibilidad de delegaciones en curso.
El *ahorro de contexto* = caracteres de entrada leídos server-side (llamadas con
`source=path`) ÷ 4 (o los tokens reales del backend, cuando los da) ≈ tokens que nunca
entraron al contexto de Claude. Detalle en la [wiki](./docs/wiki/Home.md).
## Alcance / no-objetivos
`local-delegate` es deliberadamente **texto/imagen→texto**: arma el prompt (o el payload
multimodal), hace POST a `/chat/completions` y devuelve solo texto. Cosas que **no** hace
a propósito:
- **Tool-calling local.** Los modelos locales no invocan herramientas ni ejecutan código;
eso lo sigue haciendo Claude. Añadirlo convertiría este paquete en un orquestador
paralelo, que no es el objetivo.
- **Generación o edición de imágenes.** `local_describe_image` es solo imagen→texto
(describir, leer texto visible, responder una pregunta puntual); nada de generar ni
editar imágenes.
- **Audio.** Para transcripción usa el companion
[`whisper-transcribe-mcp`](https://github.com/ZahiriNatZuke/whisper-transcribe-mcp) en
vez de intentar meter audio aquí.
- **Sustituir la suscripción.** El objetivo es conservar cuota delegando pasos mecánicos
acotados, no enrutar todo el trabajo a modelos locales.
## Hooks de Claude Code (opcional)
Recipe con dos hooks que sugieren delegar en el momento justo sin bloquear nunca la tool
original (`PreToolUse`/`Read` para archivos grandes, `PostToolUse`/`Bash` para salidas
largas de lint/tests): [`docs/recipes/claude-code-hooks.md`](./docs/recipes/claude-code-hooks.md).
## Groups de llama-swap (opcional)
Con `pip install "local-delegate-mcp[llamaswap]"` quedan disponibles dos CLIs para gestionar
**groups** de llama-swap (un modelo residente siempre cargado + un pool que se turna) con
guardrail de VRAM **y RAM de sistema** incorporado (`--ram-gb` es opcional: `llama-server`
mapea el GGUF también en RAM aunque el cómputo sea 100% GPU, así que un catálogo que cabe en
VRAM puede igual agotar la RAM en máquinas con menos de 32 GB):
```bash
local-delegate check-llamaswap --config config.yaml --vram-gb 16 --ram-gb 32
local-delegate init-llamaswap --config config.yaml --resident gemma3-4b --swap llama31-8b,qwen25-coder-14b --vram-gb 16 --ram-gb 32
```
El paquete **nunca** toca tu `config.yaml` por su cuenta — estos comandos solo corren si vos
los invocás. `init-llamaswap` corre el/los guardrail(es) antes de escribir (no escribe nada si
no cabe en VRAM o, si pasaste `--ram-gb`, en RAM) y nunca sobreescribe sin `--force` (dejando
`.bak`). Detalle completo, semántica de `groups` verificada contra el código de llama-swap, y
ritual de aplicación en [`docs/recipes/llama-swap-groups.md`](./docs/recipes/llama-swap-groups.md).
## Enlaces
- [Wiki](./docs/wiki/Home.md) · [Recipes](./docs/recipes)
- [CONTRIBUTING](./CONTRIBUTING.md) · [CODE OF CONDUCT](./CODE_OF_CONDUCT.md) · [CHANGELOG](./CHANGELOG.md)
- [Licencia MIT](./LICENSE)
 MCP Store
